Domain massnahmenpaket.de kaufen?
Wir ziehen mit dem Projekt
massnahmenpaket.de um.
Sind Sie am Kauf der Domain
massnahmenpaket.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain massnahmenpaket.de kaufen?
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Ähnliche Suchbegriffe für Springer-Text-Speech-and
Top-Angebote
Produkte zum Begriff Springer-Text-Speech-and:
-
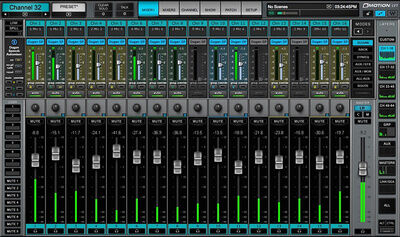
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
MONACOR Speech-500/gr Das Speech-500 Ist Die Professionelle Lösung -B-Stock-Hinweis: Bei den Artikeln der Kategorie Sales handelt es sich um Restposten oder Artikel aus Kundenretouren. Diese Artikel sind nur in begrenzter Stückzahl vorhanden, voll funktionstüchtig aber teilweise ohne Originalverpackung. Sollten Sie Fragen zu dem hier abgebildeten Produkt haben, kontaktieren Sie uns bitte vor Ihrem Kauf, um mögliche Unstimmigkeiten zu vermeiden. Wir informieren Sie gerne.: Bemerkungen zum Artikel: Gebrauchsspuren vorhanden: Das SPEECH-500 ist die professionelle Lösung: für anspruchsvolle Sprach- und Musikübertragung und ist mit innovativer Technik ausgerüstet. Das Rednerpult kann mittels Elektroantrieb stufenlos in der Höhe eingestellt werden. Ein Notebook kann platzsparend unter der durchsichtigen Pultscheibe in einem speziell dafür vorgesehenen und zweistufig beleuchtbaren Fach untergebracht werden. Keine Wünsche offen lässt das eingebaute Audiosystem sowie die UHF-PLL-Funktechnik mit Sende- und Empfangsmodul. Diese ermöglicht im Audio-Link-Betrieb die kabellose Ansteuerung von weiteren Aktivlautsprechersystemen, die mit entsprechenden Funkempfängern ausgerüstet sind (z. B. TXA-800- und TXA-1000-Serie).Professionelles, elektrisch höhenverstellbares Rednerpult mit integriertem drahtlosem Audiosystem: Eingebauter 4-Kanal-Mischverstärker mit Limiter, 50 W, Elektrische stufenlose Höhenverstellung der Pulthöhe von 85-125 cm, Pult mit durchsichtiger Sicherheitsglasplatte und beleuchtetem Fach für ein Laptop, Eingebauter UHF-PLL-Empfänger (TXA-1822MR) mit 2 x 16 einstellbaren Frequenzen (863,1-864,9 MHz) mit Diversity-System, passende Sender wie TXA-800HSE oder TXA-800HT sind optional erhältlich, Eingebauter UHF-PLL-Sender (TXA-820MT) mit 16 einstellbaren Frequenzen (863,1-864,9 MHz) zum Aufbau von Audio-Funk-Übertragungsstrecken, 3 Eingänge über Kombi-Buchse Mic (XLR)/Line (6,3-mm-Klinke), Stereo-Line-Eingang (Cinch), Gainregler, 3-fach-Klangregelung für die Kombi-Eingänge, 2 schockabsorbierende XLR-Buchsen auf dem Pultaufsatz für 2 optionale Schwanenhalsmikrofone (belegen je einen Mikrofoneingang), passendes Mikrofon EMG-650P optional erhältlich, Zusätzliche XLR-Buchse für LED-Schwanenhalsleuchte (z. B. GNL-453XLR, optional erhältlich), 24-V-Phantomspeisung für Mic-Eingang 1 und 2, 1 Stereo-Line-Ausgang über Cinch-Buchsen, 2-Wege-Lautsprechersystem mit 30-cm-Tieftöner (12") und Hochtonhorn (1"), Hochwertiges Gehäuse in Holz-Lack-Kombination, Standarddekor: Grau, lackiert, Referentenschildhalterung mit Klemmschraube montierbar, 3 zusätzliche Ablagefächer für Dokumente und andere Utensilien, 2 Lenkrollen mit Feststellbremse und 2 starre Rollen, Anmelde- und gebührenfrei in der EU.Lieferung ohne Laptop.Auch in anderen Farben erhältlich:Neben dem Standarddekor „Grau, lackiert” können Sie aus weiteren 20 Design-Optionen Ihre individuelle Farbe oder das passende Wunschdekor auswählen:Ahorn, Apfel dunkel, Buche, Buche dunkel, italienische Eiche, Eiche rötlich, Eiche rustikal, Erle, Kirsche, Kirsche dunkel, Kirsche hell,...3200,00 €*Versand: 99,00 €Sichere Weiterleitung zum Anbieter
-
Anger, Fear, Domination: Dark Passions and the Power of Political Speech, Sachbücher von William A. Galston"Anger, Fear, Domination: Dark Passions and the Power of Political Speech" ist ein tiefgehendes Sachbuch von William A. Galston, das sich mit den dunklen Kräften auseinandersetzt, die die Demokratie bedrohen. Der Autor, ein angesehener Politikwissenschaftler, analysiert, wie Emotionen wie Angst, Wut und Dominanz in der politischen Rhetorik eingesetzt werden, um Menschen zu mobilisieren. Galston argumentiert, dass die Verteidigung der liberalen Demokratie ein Verständnis dieser dunklen Leidenschaften erfordert, die oft die Oberhand gewinnen, insbesondere in Krisenzeiten. Er beleuchtet die Herausforderungen, die durch eine neue Generation von Demagogen entstehen, und betont die Notwendigkeit, sowohl auf öffentliche Politik als auch auf überzeugende Rhetorik zu reagieren. Dieses Buch bietet eine fundierte Analyse der politischen Psychologie und der emotionalen Dynamiken, die das heutige politische Klima prägen.29,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Between Text and Text, Fachbücher von Michaela Horowitz Bauks, Armin Lange, Wayne Horowitz"Between Text and Text" ist ein Fachbuch, das sich mit der Intertextualität antiker Texte und deren Rezeption in mittelalterlichen sowie modernen Zeiten beschäftigt. Es untersucht die Definitionen von Text und Intertext und beleuchtet die verschiedenen Formen, in denen Texte in Architektur, Ikonographie und Lexikographie präsentiert werden. Das Buch analysiert die Beziehung zwischen schriftlichen und mündlichen Traditionen und zeigt auf, wie antike Texte durch die ständige Wechselwirkung dieser Traditionen geprägt wurden. Zudem wird der Begriff der "Tradition" in der antiken orientalischen und antiken Literatur behandelt, wobei die Übertragung von Traditionen über kulturelle Grenzen hinweg thematisiert wird. Ein weiterer Schwerpunkt liegt auf der Beziehung zwischen Intertextualität und Kanon, wobei die Beiträge die fortlaufende historische Debatte um kulturell prägende und kanonisierte Texte beleuchten. Die Vielfalt der Perspektiven und die interdisziplinäre Herangehensweise machen dieses Werk zu einer wertvollen Ressource für Studierende und Forschende im Bereich der Kunst, Musik und Design.140,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Welches kostenlose Text-to-Speech-Programm könnt ihr empfehlen?
Ein empfehlenswertes kostenloses Text-to-Speech-Programm ist "Balabolka". Es bietet eine Vielzahl von Stimmen in verschiedenen Sprachen und ermöglicht es, Text in Audio umzuwandeln. Es ist einfach zu bedienen und bietet viele Anpassungsmöglichkeiten. **

Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Top-Angebote
Produkte zum Begriff Springer-Text-Speech-and:
-
Deep Learning for NLP and Speech Recognition, Fachbücher von Uday KamathDas Fachbuch "Deep Learning for NLP and Speech Recognition" bietet eine umfassende Einführung in die Architektur des Deep Learning und deren Anwendungen in verschiedenen Aufgaben der natürlichen Sprachverarbeitung sowie der Spracherkennung. Es adressiert die wachsende Nachfrage nach einem einheitlichen Nachschlagewerk, das die Techniken des Deep Learning mit praktischen Anwendungen in Bereichen wie Finanzen, Gesundheitswesen und Regierung verknüpft. Das Buch behandelt aktuelle Methoden des Deep Learning, die für NLP und Sprachanwendungen relevant sind, und bietet einen Überblick über moderne Ansätze sowie reale Fallstudien, die mit Codebeispielen ergänzt werden, um praktische Erfahrungen zu ermöglichen. Die Struktur des Buches ist in drei Teile gegliedert, die auf unterschiedliche Zielgruppen und deren Fachkenntnisse abgestimmt sind, und bietet somit sowohl Einsteigern als auch erfahrenen Fachleuten wertvolle Einblicke.74,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
MONACOR Speech-500/gr Das Speech-500 Ist Die Professionelle Lösung -B-Stock-Hinweis: Bei den Artikeln der Kategorie Sales handelt es sich um Restposten oder Artikel aus Kundenretouren. Diese Artikel sind nur in begrenzter Stückzahl vorhanden, voll funktionstüchtig aber teilweise ohne Originalverpackung. Sollten Sie Fragen zu dem hier abgebildeten Produkt haben, kontaktieren Sie uns bitte vor Ihrem Kauf, um mögliche Unstimmigkeiten zu vermeiden. Wir informieren Sie gerne.: Bemerkungen zum Artikel: Gebrauchsspuren vorhanden: Das SPEECH-500 ist die professionelle Lösung: für anspruchsvolle Sprach- und Musikübertragung und ist mit innovativer Technik ausgerüstet. Das Rednerpult kann mittels Elektroantrieb stufenlos in der Höhe eingestellt werden. Ein Notebook kann platzsparend unter der durchsichtigen Pultscheibe in einem speziell dafür vorgesehenen und zweistufig beleuchtbaren Fach untergebracht werden. Keine Wünsche offen lässt das eingebaute Audiosystem sowie die UHF-PLL-Funktechnik mit Sende- und Empfangsmodul. Diese ermöglicht im Audio-Link-Betrieb die kabellose Ansteuerung von weiteren Aktivlautsprechersystemen, die mit entsprechenden Funkempfängern ausgerüstet sind (z. B. TXA-800- und TXA-1000-Serie).Professionelles, elektrisch höhenverstellbares Rednerpult mit integriertem drahtlosem Audiosystem: Eingebauter 4-Kanal-Mischverstärker mit Limiter, 50 W, Elektrische stufenlose Höhenverstellung der Pulthöhe von 85-125 cm, Pult mit durchsichtiger Sicherheitsglasplatte und beleuchtetem Fach für ein Laptop, Eingebauter UHF-PLL-Empfänger (TXA-1822MR) mit 2 x 16 einstellbaren Frequenzen (863,1-864,9 MHz) mit Diversity-System, passende Sender wie TXA-800HSE oder TXA-800HT sind optional erhältlich, Eingebauter UHF-PLL-Sender (TXA-820MT) mit 16 einstellbaren Frequenzen (863,1-864,9 MHz) zum Aufbau von Audio-Funk-Übertragungsstrecken, 3 Eingänge über Kombi-Buchse Mic (XLR)/Line (6,3-mm-Klinke), Stereo-Line-Eingang (Cinch), Gainregler, 3-fach-Klangregelung für die Kombi-Eingänge, 2 schockabsorbierende XLR-Buchsen auf dem Pultaufsatz für 2 optionale Schwanenhalsmikrofone (belegen je einen Mikrofoneingang), passendes Mikrofon EMG-650P optional erhältlich, Zusätzliche XLR-Buchse für LED-Schwanenhalsleuchte (z. B. GNL-453XLR, optional erhältlich), 24-V-Phantomspeisung für Mic-Eingang 1 und 2, 1 Stereo-Line-Ausgang über Cinch-Buchsen, 2-Wege-Lautsprechersystem mit 30-cm-Tieftöner (12") und Hochtonhorn (1"), Hochwertiges Gehäuse in Holz-Lack-Kombination, Standarddekor: Grau, lackiert, Referentenschildhalterung mit Klemmschraube montierbar, 3 zusätzliche Ablagefächer für Dokumente und andere Utensilien, 2 Lenkrollen mit Feststellbremse und 2 starre Rollen, Anmelde- und gebührenfrei in der EU.Lieferung ohne Laptop.Auch in anderen Farben erhältlich:Neben dem Standarddekor „Grau, lackiert” können Sie aus weiteren 20 Design-Optionen Ihre individuelle Farbe oder das passende Wunschdekor auswählen:Ahorn, Apfel dunkel, Buche, Buche dunkel, italienische Eiche, Eiche rötlich, Eiche rustikal, Erle, Kirsche, Kirsche dunkel, Kirsche hell,...3200,00 €*Versand: 99,00 €Sichere Weiterleitung zum Anbieter
-
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Springer-Text-Speech-and
-
Anger, Fear, Domination: Dark Passions and the Power of Political Speech, Sachbücher von William A. Galston"Anger, Fear, Domination: Dark Passions and the Power of Political Speech" ist ein tiefgehendes Sachbuch von William A. Galston, das sich mit den dunklen Kräften auseinandersetzt, die die Demokratie bedrohen. Der Autor, ein angesehener Politikwissenschaftler, analysiert, wie Emotionen wie Angst, Wut und Dominanz in der politischen Rhetorik eingesetzt werden, um Menschen zu mobilisieren. Galston argumentiert, dass die Verteidigung der liberalen Demokratie ein Verständnis dieser dunklen Leidenschaften erfordert, die oft die Oberhand gewinnen, insbesondere in Krisenzeiten. Er beleuchtet die Herausforderungen, die durch eine neue Generation von Demagogen entstehen, und betont die Notwendigkeit, sowohl auf öffentliche Politik als auch auf überzeugende Rhetorik zu reagieren. Dieses Buch bietet eine fundierte Analyse der politischen Psychologie und der emotionalen Dynamiken, die das heutige politische Klima prägen.29,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Between Text and Text, Fachbücher von Michaela Horowitz Bauks, Armin Lange, Wayne Horowitz"Between Text and Text" ist ein Fachbuch, das sich mit der Intertextualität antiker Texte und deren Rezeption in mittelalterlichen sowie modernen Zeiten beschäftigt. Es untersucht die Definitionen von Text und Intertext und beleuchtet die verschiedenen Formen, in denen Texte in Architektur, Ikonographie und Lexikographie präsentiert werden. Das Buch analysiert die Beziehung zwischen schriftlichen und mündlichen Traditionen und zeigt auf, wie antike Texte durch die ständige Wechselwirkung dieser Traditionen geprägt wurden. Zudem wird der Begriff der "Tradition" in der antiken orientalischen und antiken Literatur behandelt, wobei die Übertragung von Traditionen über kulturelle Grenzen hinweg thematisiert wird. Ein weiterer Schwerpunkt liegt auf der Beziehung zwischen Intertextualität und Kanon, wobei die Beiträge die fortlaufende historische Debatte um kulturell prägende und kanonisierte Texte beleuchten. Die Vielfalt der Perspektiven und die interdisziplinäre Herangehensweise machen dieses Werk zu einer wertvollen Ressource für Studierende und Forschende im Bereich der Kunst, Musik und Design.140,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
The Generational Assault on Christianity, Free Speech and Democracy in America, 2nd Edition - Christopher Arthur Rockefeller, Audio, 9781965655016The Generational Assault On Christianity, Free Speech And Democracy In America, 2nd Edition Von Christopher Arthur Rockefeller, Lantern Audio, 978-1-965655-01-6, Sprecher: John Campbell, Sprache: Englisch11,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Free Speech, Sachbücher von Timothy Garton AshDer führende politische Schriftsteller Timothy Garton Ash präsentiert zehn Leitprinzipien für die Meinungsfreiheit im digitalen Zeitalter, die das Ergebnis eines einzigartigen globalen Gesprächs sind. Nie in der Menschheitsgeschichte gab es eine so grosse Chance für die Meinungsfreiheit. Mit Internetzugang kann jeder fast alles veröffentlichen und potenziell ein Publikum von Millionen erreichen. Dies bedeutet jedoch auch, dass die Übel einer unbegrenzten Rede leicht über Grenzen hinweg fliessen können: gewalttätige Einschüchterung, grobe Verletzungen der Privatsphäre und Flutwellen des Missbrauchs. Ein Pastor verbrennt einen Koran in Florida, und UN-Beamte sterben in Afghanistan. Basierend auf einem Leben, das dem Schreiben über Diktaturen und Dissidenten gewidmet ist, argumentiert Timothy Garton Ash, dass in dieser vernetzten Welt, die er Kosmopolis nennt, der Weg, Freiheit und Vielfalt zu verbinden, darin besteht, mehr, aber auch bessere Meinungsfreiheit zu haben. Über alle kulturellen Grenzen hinweg müssen wir uns bemühen, uns darauf zu einigen, wie wir uns uneinig sind. Er stützt sich auf ein globales Online-Projekt in dreizehn Sprachen, das von der Universität Oxford durchgeführt wird und diesem Zweck gewidmet ist. Mit lebendigen Beispielen, von seinen persönlichen Erfahrungen mit Chinas orwellschem Zensurapparat bis hin zur Kontroverse um Charlie Hebdo und einem sehr englischen Gerichtsfall, der die Lebensmittelautorin Nigella Lawson betrifft, schlägt er einen Rahmen für zivilisierten Konflikt in einer Welt vor, in der wir alle Nachbarn werden. Timothy Garton Ash ist der preisgekrönte Autor von neun vorherigen politischen Büchern, darunter zuletzt "Facts Are Subversive". Er ist Isaiah Berlin Professorial Fellow am St Antony's College, Oxford, Senior Fellow an der Hoover Institution, Stanford University, und ein regelmässiger Beitragender zu verschiedenen Publikationen. Er hat mehrere Auszeichnungen für sein Schreiben erhalten, darunter den Orwell-Preis.25,93 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Welches kostenlose Text-to-Speech-Programm könnt ihr empfehlen?
Ein empfehlenswertes kostenloses Text-to-Speech-Programm ist "Balabolka". Es bietet eine Vielzahl von Stimmen in verschiedenen Sprachen und ermöglicht es, Text in Audio umzuwandeln. Es ist einfach zu bedienen und bietet viele Anpassungsmöglichkeiten. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.